
סוכן AI לעיבוד מסמכים: מה באמת קובע את הדיוק
במדידה על 138 מסמכים אמיתיים בעברית: 94.8% מהשדות נקראו נכון, 67.4% מהמסמכים עברו בלי שום תיקון, ורק 0.6% מהשדות היו שגויים בלי סימון
יותר ויותר ארגונים מנסים להעביר לסוכני AI עיבוד של מסמכים ונתונים: קריאה, חילוץ, סיווג והזנה למערכות. הספקים מבטיחים דיוק של 95% עד 99%. מי שניסה מגלה לעתים קרובות שהעבודה לא נעלמה. היא רק עברה מביצוע לבדיקה.
וגם 99% הוא לא המספר שקובע. השאלה היא מה קורה באחוז שנשאר. טעות שהכלי מסמן נבדקת ומתוקנת. טעות שנראית תקינה עוברת בשקט למערכת, ומתגלה מאוחר, כשכבר בנו עליה החלטות.
את השאלה הזאת מדדתי על סוכן שבניתי לחשבוניות וקבלות בעברית. ב-138 מסמכים אמיתיים, רק 0.6% מהשדות היו שגויים בלי סימון. המאמר מסביר מה קובע את המספר הזה, ולמה חלק גדול ממנו נקבע סביב המודל ולא בתוכו.
מה מדדתי
המדידה נעשתה בזמן הבניה, על 138 מסמכים אמיתיים, מול ההכרעה של רואה החשבון שסקר כל אחד מהם:
67.4% מהמסמכים עברו בלי תיקון באף שדה. בשדות שנשארו ריקים הסוכן לא היה בטוח ולא ניחש. 0.6% מהשדות הם טעויות שקטות: ערך שגוי שעבר בלי סימון, ותוקן בסקירה. שדה שגם רואה החשבון השאיר ריק נספר כנכון, וטעות שגם הוא לא הבחין בה לא נספרה.
מה המחקרים מראים
המחקרים השיטתיים מציגים תמונה צנועה יותר מעמודי המכירה. במחקר מ-2026 על חילוץ נתונים פיננסיים מטקסט באנגלית, המודלים החזקים קראו נכון 89% עד 95% מהשדות, אבל רק ב-42% עד 70% מהדוגמאות היו כל השדות נכונים. בעברית גם הקריאה עצמה קשה יותר: במדד אחר מ-2026, Gemini Flash-Lite, מודל קל של גוגל, קרא 61% מהמשפטים בעברית כמעט בלי שגיאות, לעומת 95% בכתב לטיני. גם GPT-4.1 של OpenAI, מודל חזק בהרבה, הגיע בעברית ל-42% בלבד, לעומת 83% בכתב לטיני. מדד מפורסם לחילוץ שדות ממסמכים בעברית לא מצאתי, וגם הספקים בישראל מפרסמים אחוזים בלי הגדרה ובלי שיטה.
גם הטעות השקטה מוכרת במחקר. מודלי שפה מצהירים על ביטחון גבוה גם כשהם טועים, ולכן הטעויות שלהם לא בולטות לעין. מדריך מקצועי מ-2026 על כלים כאלה מנסח את זה בפשטות: הכלי “טועה בביטחון מלא”.
המחקרים האלה מודדים משימות אחרות, בשפות אחרות ועם מספר שדות אחר, ולכן הם מראים עד כמה הבעיה קשה, לא מי ניצח. ההבדל לעומת ה-95% עד 99% שבעמודי המכירה הוא אחר: כאן יש הגדרה, יש שיטה, ויש מספר לטעויות השקטות. בעיני זה הנתון החשוב: מתוך הערכים שהסוכן מסר, פחות מאחד ממאה היה שגוי בלי אזהרה.
איך זה התחיל
רואה חשבון שאני מכיר, התלונן על עומס יתר. כשהצעתי לו להעזר ב-AI, סיפר לי שעמיתיו מבזבזים זמן רב על תיקון טעויות של סוכני AI. לדבריו, הכלים האלה עדין לא מדויקים מספיק למשרד שמקפיד על כל פרט. נזכרתי בדבריו כשסיימתי את השלד הראשון של סוכן שקורא מסמכי רכב, כמו פוליסות ביטוח. הבנתי שאפשר לישם את אותה גישה במשרדים רבים שמעבדים מסמכים שחוזרים כל חודש, וישמתי אותה בסוכן לחשבוניות וקבלות.
מההתחלה נקבע קו אדום: ערך שגוי שנראה תקין לא יעבור. שדה ריק, לעומת זאת, מושך מיד את העין.
המודל קורא, והשכבה שעוטפת אותו מחליטה על מה לסמוך, מאמתת את התוצאות מול כללים ומסמנת למשתמש מה דורש הכרעה.
המודל קורא, הסוכן מחליט על מה לסמוך
הכלל הראשון של הסוכן: כשאין ודאות, השדה נשאר ריק. מכאן נובעים השדות הריקים שבמדידה, והם המחיר שאני מוכן לשלם כדי שטעויות שקטות תהיינה נדירות.
המודל אמנם מדווח כמה הוא בטוח בכל ערך, אבל הסוכן לא מסתמך על הדיווח הזה. במדידות, הביטחון שהמודל דיווח כמעט לא ניבא אם הערך נכון. לכן כל ערך עובר בדיקות שלא תלויות במודל: ציטוט, כללים וקורא שני.
המודל מחזיר את התשובה בתבנית קבועה, ולצד כל ערך את הקטע במסמך שממנו קרא אותו. בדיקה בקוד מוודאת שהקטע באמת מכיל את הערך, כך שערך שהמודל הסיק ולא קרא לא עובר. את הבדיקה הזאת הוספתי אחרי תקלה שחזרה על עצמה: המודל ציטט את השורה שבה הופיע סכום המע”מ בשקלים, וחישב ממנה את האחוז, שלא היה כתוב בה. הציטוט היה אמיתי, אבל הערך שבשדה לא הופיע בו.
החלטתי גם לא לגלות למודל שהבדיקה קימת. מודל שיודע שציטוט חסר פוסל את התשובה עלול להתחיל להמציא ציטוטים, והבדיקה תאבד את ערכה.
את ההשפעה מדדתי בתחילת הבניה, על 39 מסמכים אמיתיים ועוד בלי קורא שני. בדיקת הציטוט הורידה את השדות השגויים בלי סימון מ-4.4% ל-1.3%. המסמכים שהייתה בהם טעות כזאת ירדו מ-25.6% ל-5.1%.
אימות מול כללים
ציטוט מוכיח שהערך מופיע במסמך, אבל לא שהוא הגיוני. לכן כל שדה עובר גם אימות מול המבנה שלו ומול הכללים של התחום. בחשבוניות, למשל, הסוכן בודק את תקינות מספר העוסק ומוודא שהמע”מ מתאים לסוג המסמך. בכל סוג מסמך הכללים אחרים, אבל העיקרון זהה: ערך שלא עומד בכללים לא עובר הלאה, גם אם המודל היה בטוח בו.
מכיוון שכל שדה נבדק בנפרד, שדה אחד שנכשל באימות לא פוסל את המסמך כולו. שאר השדות עוברים, ורק הוא ממתין להכרעה.
קורא שני, מספקית אחרת
מסמך שעבר את הבדיקות נקרא פעם נוספת, בידי מודל של ספקית אחרת. שדה ששני המודלים קראו אחרת נשאר ריק, עם סימון לסקירה. בבדיקות בזמן הבניה טעו שני המודלים, למשל בהחלפת ספרה, אבל כל אחד במקום אחר. לכן ההשוואה ביניהם חושפת טעויות שכל אחד מהם היה מוסר בביטחון.
כמה זה שווה, מדדתי על מסמכים סינתטיים, שבהם התשובה הנכונה ידועה מראש. את התשובות למסמכים האמיתיים הכינו אז בעזרת אותו מודל ששימש כקורא שני, ומדידה שלו מולן הייתה מעגלית. עם קורא אחד בלבד, 96.9% מהשדות נקראו נכון. ובכל זאת, ב-6.8% מהמסמכים עבר לפחות שדה אחד שגוי בלי סימון. הקורא השני תפס 37 מתוך 37 טעויות, והטעויות השקטות בשדות שהוא בודק ירדו לאפס. המחיר הוא כפול. הקורא השני עוצר לפעמים גם שדה שהיה נכון, ולכן אחוז השדות המלאים יורד מעט. והוא מכפיל את עלות המסמך, קצת יותר מפי שניים. בתמורה, ערך שמגיע לאדם בלי סימון ראוי לאמון גבוה בהרבה.
ההכרעה האחרונה שיכת לאדם
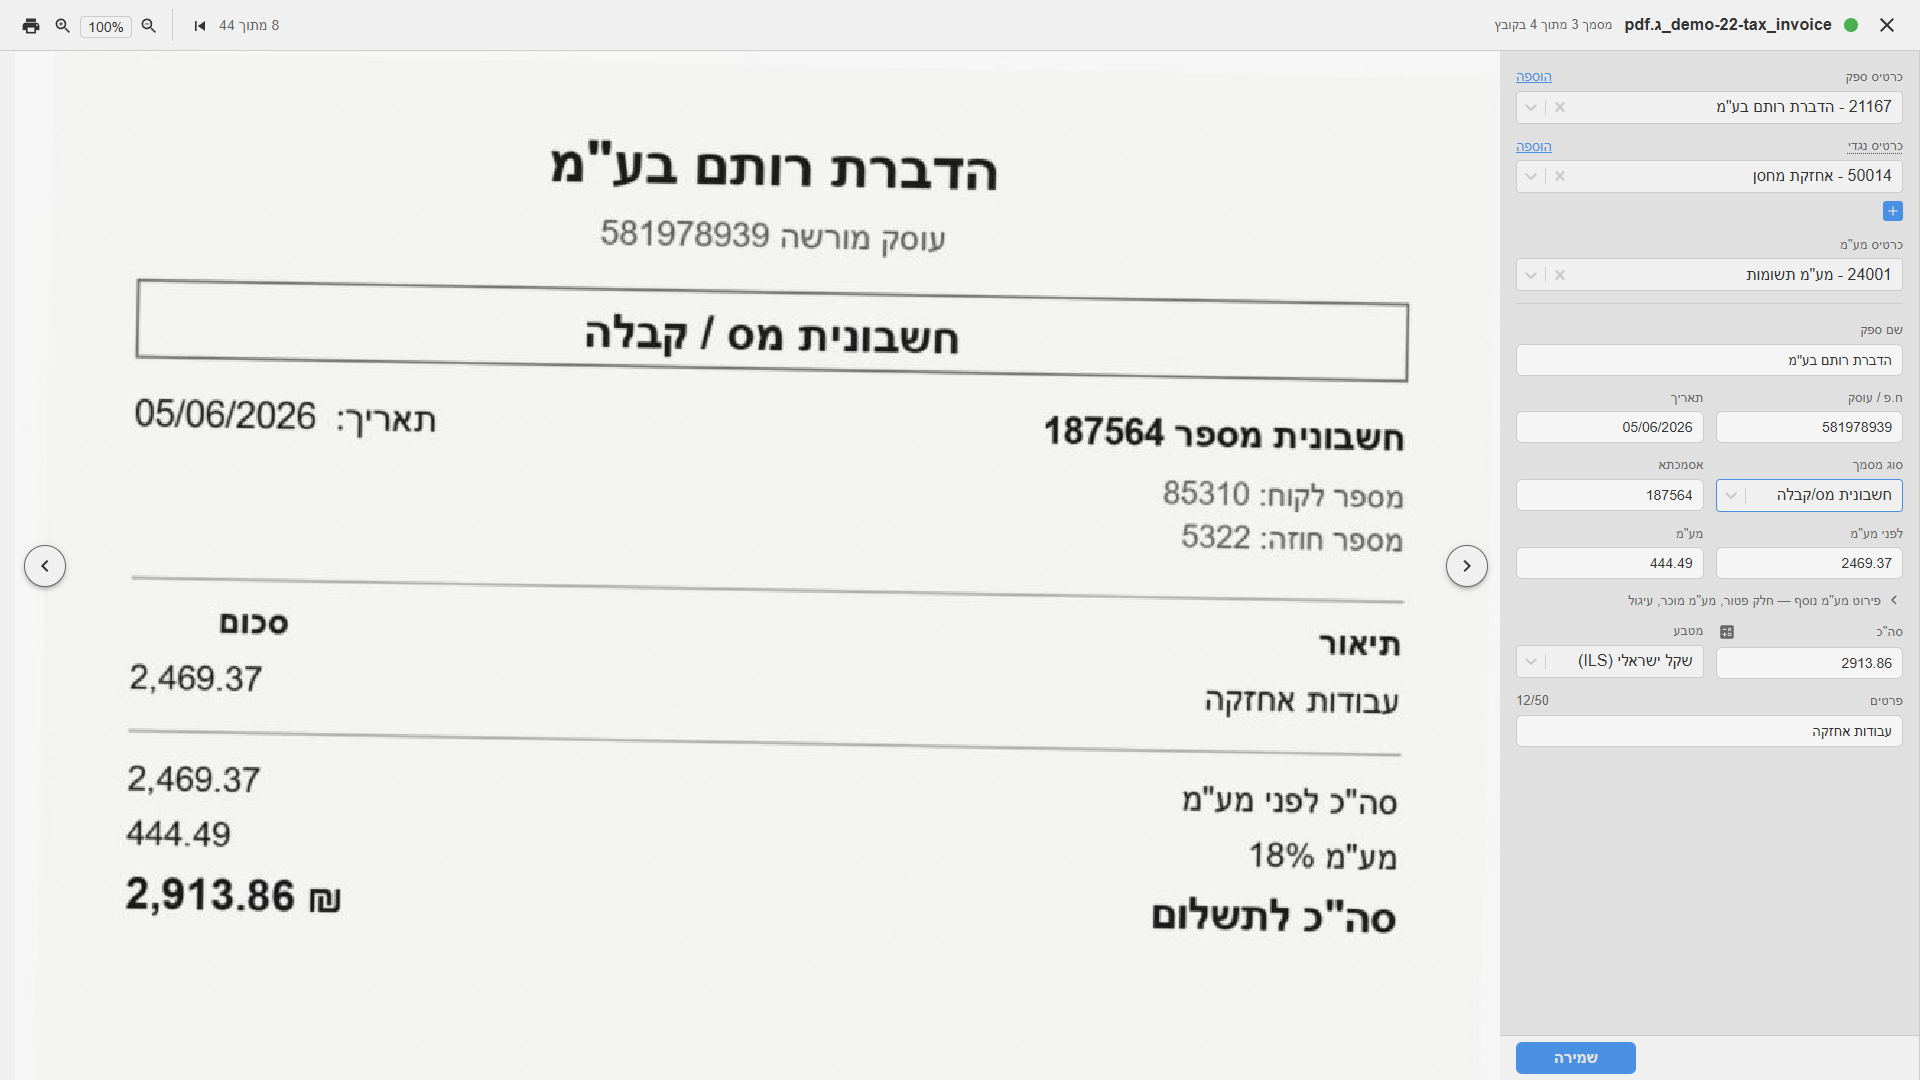
לאחר עבודת הסוכן, נתוני הקריאות וההשוואות חוזרים לתוכנה שהפעילה אותו. היא מקבלת לכל שדה את הערך שנבדק, את הציטוט ואת מה שקרא כל אחד משני המודלים. התוכנה מציגה למשתמש את המסמך לצד השדות שנקראו ממנו - עם סימון של מה שדורש החלטה. שום מסמך לא נשמר לפני שהמשתמש אישר אותו, ורק הנתונים שאושרו יוצאים למערכת היעד, למשל לתוכנת הנהלת החשבונות.
המשתמש לא מחכה ליד כל מסמך. הוא מעלה תיקייה שלמה, והסוכן מעבד כמה שיותר מסמכים במקביל. במדידות, עיבוד תיקייה לקח בממוצע דקה עד שלוש, לפי מספר המסמכים ולפי כמה מהם היו קשים לקריאה. זמן ההעלאה עצמו תלוי בחיבור האינטרנט. כשהעיבוד מסתיים, המשתמש עובר על המסמכים ברצף ומאשר. החיסכון הוא בזמן העבודה שלו: הוא כבר לא מקליד, אלא בודק ומאשר.
למדוד בלי לשקר לעצמך
שני מקרים מהבניה לימדו אותי לא לסמוך על מספר אחד שמסכם הכול.
הראשון: גרסה שגויה של בדיקת הציטוט הראתה מספר טוב יותר מהגרסה הנכונה, ובפועל פסלה מסמכים תקינים בגלל אותיות שימוש בעברית, כמו ב’ או ה’ בתחילת מילה. המספר השתפר בזמן שהסוכן הידרדר. מאז אני מסווג כל כשל לאחד משני סוגים: מסמך תקין שנפסל, או ערך שגוי שעבר.
השני: בזמן הבניה בדקתי את התוצאות גם בעזרת מודלים נוספים ששימשו כשופטים. את המקרים שבהם הם לא הסכימו עם הסוכן בחנתי בעצמי מול המסמכים. ברוב המקרים טעו השופטים, ודווקא בכללי המס הישראליים: חשבונית מס מול קבלה, או מספר עוסק מורשה מול מספר חברה. בשדות כאלה נדרש מי שמכיר את הכללים, ולכן ההכרעה הסופית תמיד בידי המשתמש.
מחיר מול דיוק בבחירת המודלים
סוכן יקר מדי לא משתלם, וסוכן שאינו מדויק מספיק הופך את כל ההשקעה לחסרת טעם. לכן האיזון בין מחיר המודל לדיוק שלו הוא בעיני אחת ההחלטות החשובות בבניה.
בקריאה הראשונה, Gemini Flash-Lite של גוגל דיק הרבה פחות מ-Flash. הגרסאות החדשות של Flash נתנו פחות מגרסה 2.5. רק גרסה 3.8 פלאש עלתה על 2.5 באחוזים בודדים, וגם זה רק כשקיבלה תקציב חשיבה גדול ומגבלת אורך תשובה גבוהה יותר. במצב כזה העלות למסמך עלתה פי ארבעה בערך, ומחירון 2027 צפוי להכפיל אותה שוב. התמורה לא שווה את המחיר.
בקורא השני ההכרעה נפלה לכיוון ההפוך. Claude Haiku של Anthropic היה חלש בהרבה ברמת המסמך השלם, ו-Opus לא שיפר על Sonnet, אף שהוא יקר ממנו. לכן בחרתי ב-Sonnet, אף שהוא יקר מ-Haiku בהרבה.
אבל הבחירה הזאת לא קבועה. הספקיות משחררות מודלים חדשים, משנות מחירים ומוציאות מודלים ותיקים משימוש. השילוב שהיה המאוזן ביותר השנה עלול להיעלם בשנה הבאה, או לעלות במחיר. השילוב משתנה בשני מקרים: כשיוצא מודל שנותן תמורה טובה יותר במחיר משתלם, או כשמודל יוצא משימוש וחייבים למצוא לו תחליף משתלם ככל האפשר. בשני המקרים אני מריץ על המועמדים את אותה מדידה, על אותם מסמכים. מבחינתי, המדידה הזאת היא חלק מהחזקת הסוכן לאורך כל חייו.
לכתוב את הסוכן, או לבנות אותו במוצר של ספקית
הספקיות הגדולות מציעות כלים לבנית סוכנים. בחלקם מגדירים את הסוכן בשפה טבעית, וחלקם ערכות פיתוח, כמו ADK של גוגל, Agents SDK של OpenAI ו-Claude Agent SDK של Anthropic, המאפשרות לבנות גם סוכן ללא כלים מובנים. בכל זאת כתבתי את הסוכן בעצמי, ב-Rust, משלוש סיבות.
שליטה בעלויות. אצל סוכן שהעבודה שלו היא קריאות מתמידות למודל שפה, הטוקנים הם רוב העלות. כל פניה למודל מכילה רק את ההוראה הקבועה, את המסמך ואת תבנית התשובה. בלי היסטורית שיחה ובלי הגדרות כלים, ותקציב החשיבה מוגבל בקוד. בסוכן שבנוי במערכת של ספקית, הכלים המובנים צורכים טוקנים בעצמם, ועל כל טוקן משלמים. זאת בנוסף לעלויות מחשוב ענן שמתווספות כדי להריץ את הסוכן. סוכן שכתוב ב-Rust צורך פחות משאבי מחשוב ועובד יעיל יותר - ודאי מכלי פייתון המקובלים בענף. זה חיסכון נוסף, אם כי קטן לעומת החיסכון בטוקנים.
אימות בקוד. הוראה בשפה טבעית אינה מחסום אבטחה, כי מסמך יכול לנסות לעקוף אותה. לכן כל תשובה עוברת אימות בקוד, ושדה שנכשל בו לא עובר הלאה.
התנהגות בכשל. כל תשובה נבדקת מול התבנית לפני שמשתמשים בה, מספר הניסיונות החוזרים מוגבל, ומפסק (circuit breaker) עוצר את הפניות אחרי כמה כשלים ברצף. הקוד עצמו מכוסה בבדיקות תוכנה.
בעיני, הפיתוח העצמי הוא השקעה חד-פעמית שמשתלמת לאורך חיי הסוכן. הוא התאים לסוכן שבו כל מסמך עולה כסף וכל טעות עולה - ולא רק בזמן.
אבטחה: המסמך יכול להיות התוקף
מי שמעלה מסמך הוא לא תמיד מי שכתב אותו. ספק יכול לשלוח חשבונית עם טקסט שמנסה לתת למודל הוראות. לכן הסוכן בנוי מתוך הנחה שהמסמך עצמו עלול לנסות להטעות.
- למודל אין כלים. הוא לא ניגש למסד הנתונים, לא מריץ פקודות ולא פונה לרשת. התשובה שלו נשמרת כנתון בלבד ולעולם לא מופעלת כפקודה. גם אם טקסט במסמך יצליח לבלבל את המודל, מה שייצא הוא ערך בשדה ולא פעולה במערכת, והערך הזה עובר את אותם אימותים ואת אישור המשתמש.
- הקובץ נבדק לפני שהמודל רואה אותו. הסוג נקבע לפי התוכן ולא לפי הסיומת, ויש תקרות לגודל, לזמן העיבוד ולזיכרון.
- רק המערכת שמפעילה את הסוכן פונה אליו, וכל פניה צריכה להוכיח שהיא באה ממנה.
- הפרדה בין לקוחות. כל לקוח מעלה ורואה רק את המסמכים שלו.
- הגנה על החשבונות ועל מפתחות ה-API. הזהות שפונה למודל נפרדת מאלה שמטפלות בנושאים אחרים - ולה הרשאה אחת בלבד: לשלוח נתונים למודל. אצל ספק שמאפשר זאת, מפתח ה-API תקף רק מהכתובת שממנה רץ הסוכן, ובחריגה מהמכסה ממשקי המודלים נחסמים, בלי למחוק דבר.
למי ששוקל סוכן כזה
סוכן לעיבוד מסמכים לא נמדד באחוז אחד שמופיע בעמוד המכירה. הוא נמדד בשאלה כמה טעויות עוברות בשקט, וכמה עבודה נשארת למשתמש. אם יש אצלכם מסמכים שחוזרים כל חודש ומוקלדים ביד, אשמח להדגים לכם איך סוכן כזה עובד. הסוכן שעליו נערכו המדידות מתואר בעמוד יעודי.
מקורות: Cleanlab, arXiv 2603.18014 (חילוץ נתונים פיננסיים מטקסט באנגלית, מעבר אחד של המודל, בלי בדיקה אנושית) · GlotOCR Bench, arXiv 2604.12978 (קריאת משפטים בעברית מול כתב לטיני, Gemini 3.1 Flash-Lite, 100 משפטים בעברית) · Xiong ואחרים, ICLR 2024 (ביטחון יתר של מודלי שפה) · doctorai.co.il (מדריך 2026).